生成AIがもっともらしい誤りを自信を持って答えるハルシネーション。OpenAIの研究とAnthropicの公式ドキュメントをもとに、起きる理由、指示の工夫、業務で誤りを見つける確認手順と社内で決めることを整理します。
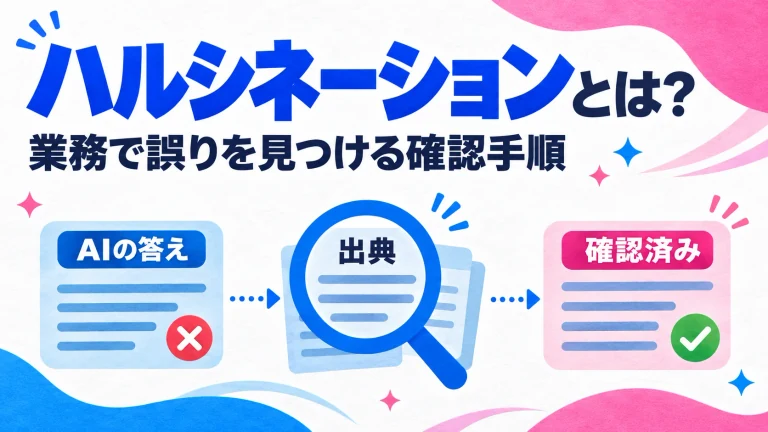
結論:ハルシネーションとは、生成AIが、もっともらしいのに正しくない内容を、自信を持って答えてしまう現象です。OpenAIもAnthropicも、最新のモデルでも起きると説明しています。完全になくす方法は示されていないため、業務では「AIに確かめさせる指示」と「人が確かめる手順」の2つで、誤りを見つけて止める仕組みを作るのが現実的だと筆者は考えます。
「AIに聞いたら、ありもしない法律や商品名が出てきた」「数字がもっともらしいのに、出典を見たら違っていた」。生成AIを仕事で使うと、こうしたことが起こりえます。これがハルシネーションです。
本記事は、2026年11月13日時点の、OpenAIの研究の解説(2025年9月5日公開)とAnthropicの公式ドキュメント「Reduce hallucinations」をもとに、ハルシネーションが起きる理由と、業務で誤りを見つける確認手順を、専門知識がなくても使える形で整理します。
出典:OpenAI「言語モデルでハルシネーションがおきる理由」、Anthropic「Reduce hallucinations」(英語のページ)。どちらも2026年11月13日に確認しました。
1. ハルシネーションとは:もっともらしい誤りを自信を持って答える現象
ハルシネーションとは、生成AIが、事実と違う内容や、渡した資料と食い違う内容を、正しいことのように出力してしまう現象です。英語で「幻覚」を意味する言葉から、こう呼ばれています。
OpenAIは、ハルシネーションを、言語モデルが生成する、もっともらしく聞こえるが正しくない発言だと説明しています。Anthropicの公式ドキュメントも、最も進んだモデルでも、事実と違う文章や、与えた文脈と食い違う文章を作ることがあると書いています。
やっかいなのは、誤りが「いかにも正しそうな文章」で出てくる点です。OpenAIの解説では、研究者が人気のチャットボットに自分の博士論文の題名を尋ねたところ、自信を持って3つの違う答えが返り、どれも正しくなかったという例が紹介されています。
業務で起きやすいのは、次のような場面です。
場面 | 起きやすい誤りの例 |
|---|---|
調べものの要約 | 存在しない資料名・URL・数字を出典のように書く |
法律・制度の説明 | 条文や制度の名前、適用の条件を取り違える |
社内資料の要約 | 資料に書いていないことを付け足す、数字を写し間違える |
人物・会社の紹介 | 経歴・設立年・所在地などを、それらしく作ってしまう |
商品・料金の案内 | 古い料金や、存在しないプランを答える |
表の例は、公式の資料の説明をもとに、業務での使い方に当てはめた筆者の整理です。
2. なぜ起きるのか:OpenAIの研究が示した2つの理由
OpenAIは、2025年9月5日の研究の解説で、ハルシネーションが起きる理由を2つ挙げています。
理由1:分からなくても「答えたほうが点が上がる」採点になっている
多くの評価は、正しく答えた割合(正答率)だけでAIを採点します。OpenAIは、これを多肢選択のテストにたとえています。答えが分からなくても、当てずっぽうで書けば当たるかもしれませんが、空欄にすれば必ず0点です。同じように、正答率だけで比べると、「分かりません」と答えるAIより、推測で答えるAIのほうが良く見えてしまいます。
解説には、OpenAIがGPT-5について公開した説明資料(System Card)に載っている、SimpleQAというテストの結果が紹介されています。どちらもOpenAIのAIモデルの名前で、o4-miniのほうが古いモデルです。
項目 | gpt-5-thinking-mini | OpenAI o4-mini |
|---|---|---|
答えなかった割合 | 52% | 1% |
正しく答えた割合 | 22% | 24% |
誤って答えた割合 | 26% | 75% |
正答率は古いo4-miniのほうが少し高いのに、誤りの割合はずっと高くなっています。o4-miniは答えなかった割合が1%と低く、OpenAIは、不確かなときに推測で答えると正答率は上がるが、誤りも増えると説明しています。この数字は特定の評価の結果で、ふだんの業務での誤りの割合を表すものではありません。
理由2:めったに出てこない事実は、パターンから予測できない
生成AIは、大量の文章を読み、「次に来る言葉」を予測する学習をしています。綴りや括弧の対応のように決まったパターンがあるものは、学習が進むと誤りがほぼなくなります。一方、OpenAIは、ペットの誕生日のように、めったに出てこず、パターンのない事実は、学習からだけでは予測できないため、ハルシネーションにつながると説明しています。
業務に当てはめると、中小企業の細かい情報、最新の料金、地域の制度、社内だけの事情などは、AIが正しく知っている見込みが低い情報だと、筆者は考えます。
3. なくせるのか:OpenAIとAnthropicの説明
OpenAIは、答えようのない質問が現実にある以上、正確さが100%になることはないと説明しています。一方で、AIは不確かなときに答えを控えることができるので、ハルシネーションは防げるとも書いています。分からないときに答えを控えれば、自信を持って誤ることは減らせる、という考え方です。
Anthropicの公式ドキュメントも、紹介している対策はハルシネーションを大きく減らすが、なくしはしないとし、重要な情報、特に影響の大きい判断では必ず確かめるよう案内しています。
筆者は、業務で大事なのは「ハルシネーションが起きないAIを探すこと」ではなく、「起きても気づいて止められる手順を作ること」だと考えます。
4. 起きやすい頼み方と、起きにくい頼み方
同じAIでも、頼み方によってハルシネーションの起きやすさは変わります。2で見た理由をもとに、業務での頼み方を比べると、次のように整理できます。表は、公式の資料の説明をもとにした筆者の整理です。
起きやすい頼み方 | 起きにくい頼み方 | 理由 |
|---|---|---|
「〇〇社の設立年と代表者を教えて」 | 「この会社概要のページの文章から、設立年と代表者を抜き出して」 | めったに出てこない事実を、記憶から答えさせないため |
「この制度の条件を教えて」 | 「この公的機関の資料に書いてある条件だけを、引用付きでまとめて」 | 資料の外の知識で補わせないため |
「最新の料金を教えて」 | 「今日開いた料金ページの表を、見やすく並べ直して」 | 学習した時点より新しい情報は知らないことがあるため |
「必ず答えて」 | 「分からなければ、分からないと答えて」 | 推測で答えるより、答えを控えるほうを選べるようにするため |
まとめると、AIには「知っていることを思い出させる」より、「渡した資料を読ませて、整理させる」頼み方のほうが、誤りを減らしやすいと筆者は考えます。
5. AIに出す指示で減らす4つの工夫
Anthropicの公式ドキュメント「Reduce hallucinations」は、指示(プロンプト)の工夫でハルシネーションを減らす方法を紹介しています。Claude向けの案内ですが、筆者はChatGPTなどほかのAIでも使える考え方だと考えるので、業務向けに言い換えて紹介します。
- 「分からなければ、分からないと答えてください」と書く:不確かなことを認めてよいと明示的に許すと、誤った情報を大きく減らせると説明されています。
- 先に資料から「そのままの引用」を抜き出させる:長い資料(目安として数万字以上)を扱うときは、まず資料の文章をそのまま抜き出させ、その引用をもとに答えさせます。筆者は、資料に書いていないことを付け足しにくくなると考えます。
- 主張ごとに出典を付けさせ、裏づけのないものを取り下げさせる:答えのあとで、各主張を裏づける引用を探させ、見つからない主張は取り下げるよう指示します。
- 渡した資料の情報だけを使わせる:「この資料に書いてあることだけで答えてください」と指示し、AIが一般の知識で補わないようにします。
ほかに、同じ指示を何回か出して答えを比べ、食い違いがあればハルシネーションを疑う方法も紹介されています。
Q. 社内の資料を読ませれば、ハルシネーションは起きませんか?
A. 起きにくくはなりますが、なくなりはしません。Anthropicの公式ドキュメントは、資料と食い違う文章を作ることもハルシネーションに含めています。資料を渡す場合も、上の2〜4の工夫を組み合わせ、最後は人が確かめます。社内の資料をAIに読み込ませる仕組み(RAG)については、別の記事で解説しています。
6. 業務で誤りを見つける確認手順
AIの答えを業務で使う前に、次の順で確かめる手順を決めておくと、担当者によるばらつきを減らせます。以下は、公式の資料の考え方をもとにした筆者の提案です。
- 使い道で確認の深さを決める:社内のアイデア出しなら軽く、お客様に出す文書・数字・法律・料金にかかわる内容は必ず確かめる、と決めておきます。
- 固有名詞・数字・日付に印を付ける:人名、会社名、商品名、金額、日付、条文の番号など、誤りが起きやすい部分を拾い出します。
- 一次情報で確かめる:拾い出した部分を、公式サイト、公的機関の資料、社内の元の資料など、元の情報で照らし合わせます。AIが示した出典のURLも、実際に開いて中身を確かめます。
- 確かめられない部分は削るか、表現を変える:裏づけが取れない内容は使わないか、「〜と案内されています(確認日時点)」のように範囲を限って書きます。
- 確かめた人と日付を残す:お客様に出す文書は、誰がいつ確かめたかを残しておくと、あとで誤りが見つかったときに直しやすくなります。
当社でも、AIに書かせた記事の下書きを、別のAIに出典の資料とだけ照らし合わせて確かめさせたところ、1本あたり十数件から20件ほど、出典に書かれていない言い切りや、出典より強い言い方が見つかりました。数字や日付の誤りより、「〜と説明しています」と書きながら実は出典にない、という種類のものが目立ちました。それ以来、書く作業と確かめる作業を分け、確かめる側には出典の資料だけを渡すようにしています。
Q. AIが出典のURLを書いてくれれば、確かめなくてよいですか?
A. 確かめる必要があります。AIが示す出典も、ほかの文章と同じく誤りがありうると筆者は考えるためです。Anthropicも、各主張を裏づける引用を探させ、見つからない主張は取り下げさせる方法を案内しています。リンクを実際に開き、その中にAIの答えと同じ内容が書いてあるかまで見てください。
7. 社内でAIを使うときに決めておくこと
ハルシネーションへの備えは、一人ひとりの注意だけに任せず、会社の決まりにしておくと安心です。筆者は、少なくとも次の3つを決めておくことをおすすめします。
決めること | 例 |
|---|---|
AIの答えをそのまま使ってよい範囲 | 社内メモの下書きはよい。お客様向けの文書・見積もり・契約に関わる文章は、確認なしでは使わない |
必ず人が確かめる項目 | 数字・日付・固有名詞・法律や制度・料金・医療や健康に関わる内容 |
確かめ方と記録 | 一次情報で照らし合わせる。確かめた人と日付を残す |
AIを安全に使うための基本ルールや、ChatGPTを会社で使う前に決めることは、別の記事でもまとめています。あわせて読むと、社内の決まりを作りやすくなります。
8. よくある疑問
Q. 新しいモデルなら、ハルシネーションは気にしなくてよいですか?
A. 気にする必要があります。OpenAIは、GPT-5は特に推論でハルシネーションが大きく減ったとしつつ、それでも起きると説明しています。新しいモデルでも、確認の手順は変えないのが安全です。
Q. 「分からない」と答えるAIは、性能が低いのですか?
A. そうとは限りません。OpenAIの解説では、分からないときに答えを控えるほうが、自信を持って誤るより良いとし、誤りは答えないことより問題だとしています。業務では、むしろ「分からない」と言えるように指示するほうが安全です。
Q. ハルシネーションを見つけたら、どうすればよいですか?
A. その答えは使わず、一次情報で正しい内容を確かめて直します。同じ種類の誤りが続くときは、指示に「資料に書いてあることだけで答える」「分からなければ分からないと答える」を加えると、減らせることがあります。
9. まとめ
- ハルシネーションは、生成AIが、もっともらしいのに正しくない内容を、自信を持って答える現象。最新のモデルでも起きる。
- OpenAIの研究は、正答率だけの採点で推測が有利になること、めったに出てこない事実はパターンから予測できないことを、理由に挙げている。
- OpenAIは不確かなときに答えを控えれば防げるとし、Anthropicは対策で大きく減らせるがなくなりはしないとしている。指示の工夫(分からないと言ってよい、引用させる、出典を付けさせる、資料だけを使わせる)で減らす。
- 業務では、固有名詞・数字・日付を一次情報で確かめる手順と、社内の決まりで、誤りを見つけて止める(筆者の提案)。
略歴
- 2011年
- GMOインターネット株式会社に入社
- 2013年
- 株式会社エクスコアに創業メンバーとして参画
- 2025年
- 株式会社curveを創業
会社紹介
株式会社curve
株式会社curveは、デジタルマーケティング事業(Google広告・Yahoo!広告・SNS広告の運用、SNS運用、SEO対策・MEO対策・AIO対策)、クリエイティブ事業(AIホームページ制作・YouTube動画制作)、AI導入支援事業(AI法人研修・AI顧問)により、顧客獲得から、対応・運用の仕組みまで一貫して支援します。AIテックベースは、株式会社curveが運営しています。
- デジタルマーケティング事業広告運用(Google広告・Yahoo!広告・SNS広告)・SNS運用・SEO対策・MEO対策・AIO対策(AI検索対策)
- クリエイティブ事業AIホームページ制作(ホームページ・LP)・YouTube動画制作
- AI導入支援事業AI法人研修・AI業務自動化・AI顧問
- 所在地
- 東京都渋谷区渋谷1丁目1番3号 3F
- 創業
- 2025年10月